5 Zusammenfassung Vorlesungen
6 Zusammenfassung
7 VL 1: Forschungszyklus
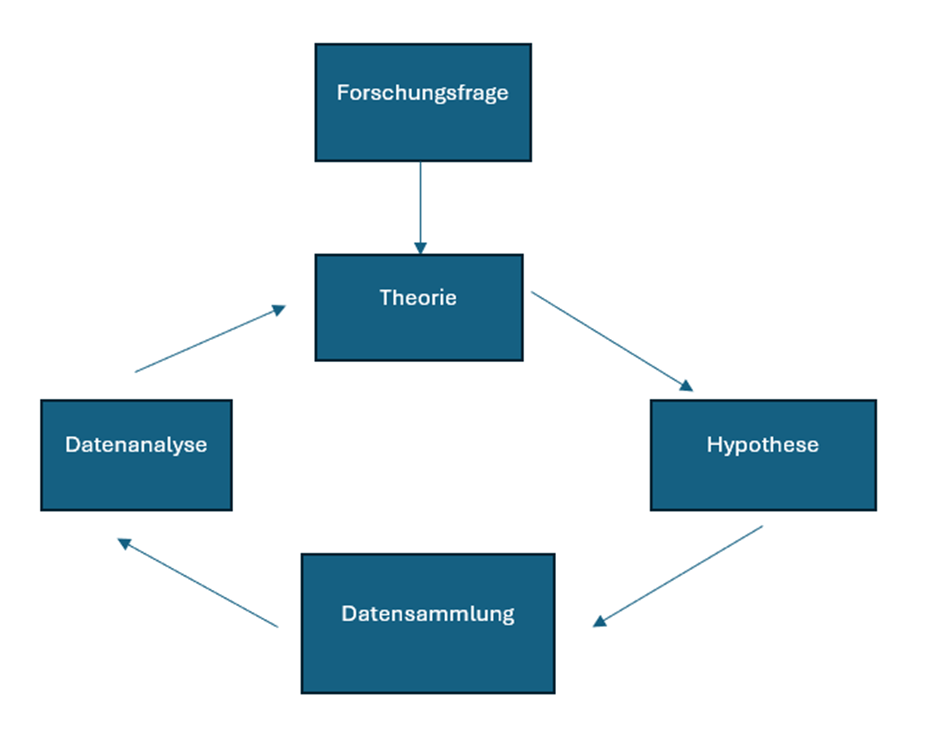
Forschungsfrage = Eine Frage, die das Phänomen oder Problem aufgreift.
Theorie = Eine Erklärung, weshalb etwas geschieht
Datensammlung = systematische Sammlung und Messung von relevanten Variablen
Hypothese = eine theorie-geleitete Erwartungen über einen empirischen Zusammenhang, denn wir beobachten können
Datenanalyse = Unterstützen die Daten die Theorie?
Was sind quantitative Methoden? eine Sammlung von Instrumenten, die wir zur Untersuchung von Forschungsfragen und Theorien einsetzen können
8 VL 2: Kausalität I
8.1 Weshalb Kausalität?
- Ursache-Wirkungs-Beziehungen sind das Herzstück der meisten sozialwissenschaftlichen Theorien.
8.2 X – Y Schema
Kausale Zusammenhänge könne im X-Y Schema formuliert werden: Verursacht X kausal Y?
Abhängige Variable oder «outcome»: das ist, die Variable, wo wir Wirkung sehen wollen
Unabhängige Variable oder «treatment»: Ja, Nein Frage
8.3 Counterfactuals
Immer wenn jemand eine kausale Aussage macht, vergleichen sie das, was sie beobachten (etwas faktisches), mit dem, was sie glauben, dass sie beobachten würden, wenn eine Schlüsselbedingung anders wäre (etwas kontrafaktisches, das counterfactual).
8.4 Problem der Counterfactuals
Wir können sie nicht direkt beobachten.
8.5 Behandlung und Ergebnis
Treatment = «Ursache» -> Wo die Veränderung ihren Ursprung hat
Outcome = Was von der Veränderung betroffen ist.
8.6 Binäre Variablen
Xi = 1, wenn Beobachtung i treated ist.
Xi = 0, wenn Beobachtung i nicht treated ist.
8.7 Binäre Variablen
- Yi ist das Ergebnis
8.8 Potential Outcomes
Die potenziellen Ergebnisse von Y sind die Werte von Y, die für verschiedene Werte von X realisiert würden.
8.9 Kausaler Effekt
Yi(1) – Yi(0)
8.10 Average Treatment effect
durchschnitt aller treatment effects.
8.11 Das Fundamentalproblem der kausalen Inferenz
Wir beobachten immer nur ein potenzielles Ergebnis für eine bestimmte Person, und unser beobachtetes Ergebnis hängt vom Status unserer erklärenden Variable ab.
Keine kausalen Effekte für Einzelpersonen berechnen
Wir müssen counterfactuals schätzen für den Vergleich mit realisierten Ergebnissen.
8.12 Randomisierte Experimente
Beobachtungen werden zufällig unterschiedlichen X-Werten zugewiesen
Forschende greifen direkt in die reale Welt ein
Goldstandard für kausale Inferenz
8.13 Beobachtungsstudien
Beobachtungen werden von der Natur unterschiedlichen X-Werten zugewiesen
Forschende beobachten die Welt
Sehr häufiger Ansatz in den Sozialwissenschaften
8.14 Randomisierung und selection bias
Randomisiertes treatment beseitigt nicht Unterschiede zwischen Beobachtungen, aber sorgt dafür, dass es keine systematischen Unterschiede nach Gruppen (treatment, control) geben sollte.
8.15 Konsequenz der Randomisierung
Man kann den durchschnittlichen kausalen Effekt schätzen
Niemals individuelle kausale Effekte schätzen!
Mittelwertsvergleich ist unverzerrter Schätzer für ATE
8.16 Was passiert, wenn treatment X zufällig zugewiesen wird?
Einziger systematische Unterschied: wer hat treatment erhalten und wer nicht?
Gruppen ähnlich (Normalverteilung)
8.17 Weshalb verwenden wir nicht ausschliesslich Experimente?
Praktische Bedenken: es ist nicht immer möglich treatment zu randomisieren (Z.B. Wahlsysteme)
Ethische Bedenken
Ressourcen: Experimente sind sehr teuer und aufwendig
9 VL 3: Beschreibung und Vorhersage
9.1 1. Was ist ein Modell
- Vereinfachte Abstraktion der Realität
- Wir brauchen Modelle, um Schlüsselelemente eines komplizierten Prozesses zu beschreiben
- Ein Modell soll nicht alle Eigenschaften der Realität abbilden, sondern nur diejenigen, die wir brauchen, um ein Phänomen zu beschreiben.
9.2 2. Repetition: Korrelation
- Korellationskoeffizient rho beschreibt Korrelation zwischen zwei kontinuierlichen Variablen
- Liegt zwischen 1 und -1
- 0 = keine Korrelation, 1 = stark positiv, -1 = stark negativ
9.3 3. Das lineare Regressionsmodell
Grundsätzlich: Beziehungen zwischen zwei Variablen lassen sich am einfachsten durch eine Gerade beschreiben
Was ist das lineare Regressionsmodell? Es ist eine Approximation der Beziehung zwischen der unabhängigen Variable X (erklärende) und der abhängige Variable Y.
Die Repräsentation der Gerade:
\[ Y = a + bX \]
- A = ist dabei die Konstante, der Wert von Y wenn X = 0
- B ist die Steigung = Die Veränderung von Y wenn X um eine Einheit ansteigt
- Lineare Regressionsmodell = eine Einfache Möglichkeit um den Zusammenhang zwischen zwei Variablen zu beschreiben, ist die Annahme dass sie linear verbunden sind
9.3.1 Faktoren des linearen Regressionsmodell:
- Y = abhängige Variable
- X = unabhängige Variable
- i = Beobachtungen
- A = Konstante (alpha)
- B = Steigung (beta)
- Ei = Fehlerterm / Residuum
9.4 Das Residuum
- Repräsentiert alle Faktoren abgesehen von X; die Y beeinflussen aber nicht im Modell enthalten sind -> gäbe es Ei nicht, wären alle Variablen perfekt auf der Gerade
9.5 Prozentpunkte versus Prozent!
- Prozentpunkte = die Anzahl Prozentpunkte die verändert
- Prozent = wie viel Prozent ändert sich es?
- Nicht das selbe!!
9.6 Werte vorhersagen
- In Gleichung einsetzen
9.7 Schätzen von alpha und beta
- OLS: ordinary least squares
- Formal: Von allen möglichen Werten α und β, werden die Werte α̂ und β̂ resultieren, die die Summe der quadrierten Residuen minimiert.
9.8 Regression oder Korrelation
- Korrelation positiv, dann ist Steigung beta auch positiv
- Regression oder Korrelation? Wir benutzen Regression, weil diese flexibler ist -> man kann mehrere unabhängige Variable ins Modell einschliessen und man kann auch nicht-lineare Zusammenhänge untersuchen!
9.9 Gütemass = Measure of Fit
- Gütemasse beschreiben wie gut eine Modell zu den Daten passt -> Wie gut kann es die Variation in den Daten erfassen?
9.10 R² – erklärte Varianz
- Misst die erklärte Varianz, also der Anteil der Varianz in Y, die vom Modell (mit X) «erklärt» wird.
- Zwischen 0 und 1
- Wenn 1 = perfektes Modell
- Wenn 0 = keine Varianz kann mit Modell erklärt werden
9.11 R² und Residuen
- R² ist zwischen 0 und 1
- Wenn die Residuen (Vorhersagefehler) unseres Modells gross sind, dann ist R² näher bei 0
- Wenn die Residuen (Vorhersagefehler) unseres Modells klein sind, dann ist R² näher bei 1
9.12 Wie hilfreich ist R²?
- Sagt, wie gut unabhängige Variable Y vorhersagen kann
- Sagt nicht, ob es Kausalität gibt und sagt uns nicht wie wertvoll Modell ist.
10 VL 04: Regression II
Die Grenzen der einfachen linearen Regression: Sobald mehr als 2 Variablen benutzt werden, funktioniert die einfache lineare Regression nicht mehr! Lösung: multiple lineare Regression
10.1 Multiple lineare Regression:
Kann eine abhängige Variable unter der Verwendung von mehr als einer unabhängiger Variable beschreiben
Formel:
\[ Y = a + bX_1 + bX_2 \dots \]
-> für jede neue erklärende Variable ein neues Beta!
10.2 Interpretation der Betas
Jeder Koeffizient Beta beschreibt den Zusammenhang in den Daten zwischen dieser unabhängigen Variable und der abhängigen Variable, während man für die anderen unabhängigen Variablen kontrolliert.
Koeffizienten BETA zeigen deshalb partielle Zusammenhänge!
10.3 Interpretation von Alpha:
Je mehr Variablen im Modell, desto eher verliert Alpha eine relevante substantielle Bedeutung
Alpha = Wert von Y wenn alle X Variablen gleich 0 sind
10.4 Werte vorhersagen in der multiplen Linearen Regression
- Wie einfache lineare Regression → einfach Daten einsetzen!
10.5 Binäre Variablen
Integration von qualitativer Information
Z.B. Informationen über verschiedene Gruppen
Das machen wir indem wir Dummy Variablen (= Variablen, die kategorielle Daten numerisch zeigen) nutzen.
Eine Kategorie wird keine Dummy Variable haben, das ist die Referenzkategorie
Die Wahl der Referenzkategorie ist nicht wichtig, da die Resultate immer äquivalent sind
Der Koeffizient für eine dieser Dummy Variablen ist der erwartete Unterschied zwischen der Kategorie und der Referenzkategorie
10.6 Interaktionen
Definition: Eine Interaktion besteht zwischen zwei erklärenden Variablen, wenn die Beziehung zwischen einer von ihnen und der abhängigen Variable vom Wert der anderen abhängt
Produkt der zwei erklärenden Variablen kann in das Modell eingebaut werden.
10.7 R² für die multiple Regression
- R² hier: Anteil der Varianz von Y, die im Modell von den Variablen X1….Xk erklärt werden kann.
10.8 Adjusted R²
R² wird fast immer steigen und nie fallen, wenn man eine zusätzliche Variable X einfügt
Deshalb adj. R²:
Hat einen Term eingebaut für zusätzliche Variablen
Steigt nicht immer, wird immer kleiner sein als R² und hat keine klare Interpretation
11 VL 05: Regression III
11.1 Konditionale Zusammenhänge
Modelle ohne «konstante Zusammenhänge»
Idee: Variablen die sich gegenseitig beeinflussen
Lösung: Wir fügen das Produkt der erklärenden Variablen hinzu
11.2 Wie werden die Koeffizienten geschätzt?
Werden anhand der geteilten Variation zwischen X und Y geschätzt
Je mehr Varianz von Y durch X erklärt wird werden, desto grösser ist R²
Wir schätzen die Koeffizienten mit OLS
11.3 Varianz/Kovarianz von Y, X1, X2 usw…
Überlappen sich
Wenn X1 und X2 korrelieren haben wir eine perfekte Multikollinearität
11.4 Folgen der perfekten Multikollinearität:
Man kann b1 und b2 nicht schätzen
Fehler der Analyst:in
11.5 Binäre Variablen
Wie können wir dies interpretieren?
Wir brauchen die Ableitung
Das ist folgendes:
\[ b_1 + b_3 * x_2 \]
-> marginaler Effekt von X1 auf Y
11.6 Interaktion einer Variable mit sich selber
- Da fügen wir einfach ein X² hinzu zum Model
11.7 Interpretation der Interaktion mit sich selber
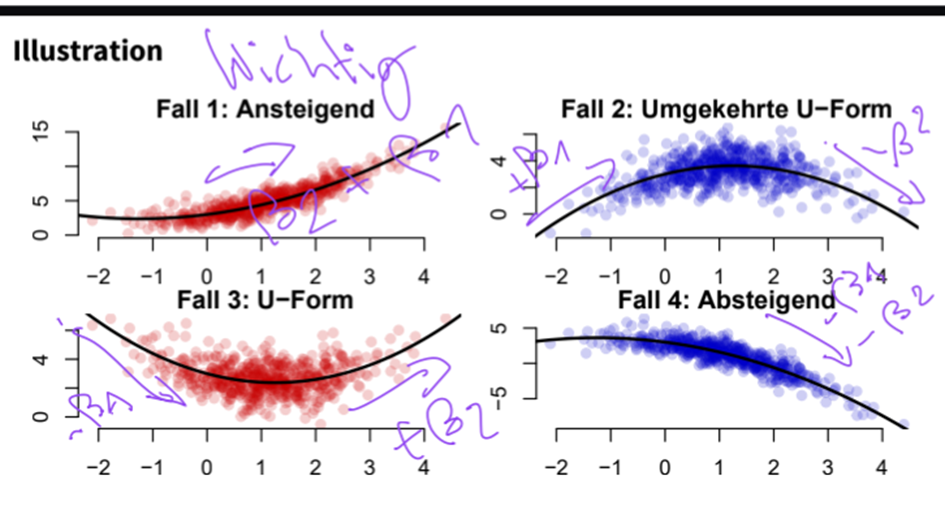
Fall 1: beide Koeffizient sind postiv
Fall 2: bx positiv, bx2 negativ
Fall 3: bx negativ, bx2 postiv
Fall 4: beide sind negativ
12 VL 06: Regression IV & Kausalität II
12.1 Datenquellen:
Beobachtungsdaten: Daten, die in realen Welt beobachtet werden
Experimentelle Daten: Daten, die durch Experimente erstellt werden (randomisiert).
12.2 Randomisierung und Regression
Differenz der Mittelwerte = unverzerrte Schätzung des kausalen Effekts, wenn unser «treatment» den Beobachtungen zufällig zugewiesen wird.
Differenz der Mittelwerte = Koeffizient für eine binäre Variable in einer einfachen linearen Regression
Also: wenn das Treatment randomisiert ist, liefert der lineare Regressionskoeffizient eine unverzerrte Schätzung des kausalen Effekts!
12.3 Vorteile der Regression bei der Analyse von experimentellen Daten
Heterogene Treatment Effekte
Sind die Effekte des Treatments je nach Gruppe unterschiedlich?
Man kann das mit Interaktionen analysieren
Nicht-binäre treatments
Ist das treatment kontinuierlich? Kategorial?
Analyse: kontinuierliche Variable im Modell oder dann mit «Factor» Dummies generieren
Erhöhung der Präzision unserer Schätzung
- Die Kontrolle anderer Faktoren, die das Ergebnis bestimmen, kann die Schätzungen der «treatment» Effekte präzisieren
12.4 Heterogene treatment Effekte
Average treatment effect haben wir besprochen
Aber vielleicht will man wissen, ob das «treatment» unterschiedliche Effekte hat für unterschiedliche Gruppen. → das kann man mit Interaktionen zwischen erklärenden Variablen beantworten.
12.5 Interaktion – Repetition
Definition Interaktion: Eine Interaktion liegt dann vor, wenn die Beziehung zwischen einer erklärenden Variable (X1) und unserer abhängigen Variable (Y) vom Wert einer anderen erklärenden Variable (X2) abhängt.
12.6 Nicht-binäre Treatments
Treatments können nicht binär sein
Beispiele:
die Wirkung verschiedener Ausgabenniveaus auf die Haushaltsgenehmigung (kontinuierlich)
Auswirkung der Arten von Wahlkampfmaterialien auf die Wahlbeteiligung (kategorisch)
12.7 Confounding
Definition: Confounding liegt vor, wenn es zwischen ‘treatment’ und ‘control’ Gruppe Unterschiede neben des treatment status gibt (d. h. Beobachtungen, die unterschiedliche Werte auf einer anderen unabhängigen Variablen annehmen), und die Variable das Ergebnis auch beeinflussen können.
12.8 Beispiele für kein Confounding
X1 -> Y, X2 kein Einfluss
X2 -> X1 -> Y
X2 -> Y und X1 -> Y -> das wird in Randomisierung ausgenutzt
X1 -> X2 -> Y und X1 -> Y
12.9 Beispiele für Confounding
X1 -> Y und X2 -> X1 und X2 -> Y
Extremes confounding: X2 hat kausalen Einfluss auf Y und X1
12.10 Omitted Variable Bias
- Definition: Bei der Regression wird das Versäumnis einen confounding Faktor miteinzubeziehen, gewöhnlich als omitted variable bias (OVB) bezeichnet.
12.11 Bedingungen:
Wenn unsere X-Variable (X1) von einer anderen X-Variable (X2) beeinflusst wird, die nicht in die Analyse einbezogen wurde
Wenn unsere ausgelassene Variable (X2) einen kausalen Effekt auf unsere Y-Variable hat
Confounding Variable = Variable die ausgelassen worden ist und confounding verursacht.
12.12 Multiple lineare Regression & Confounding
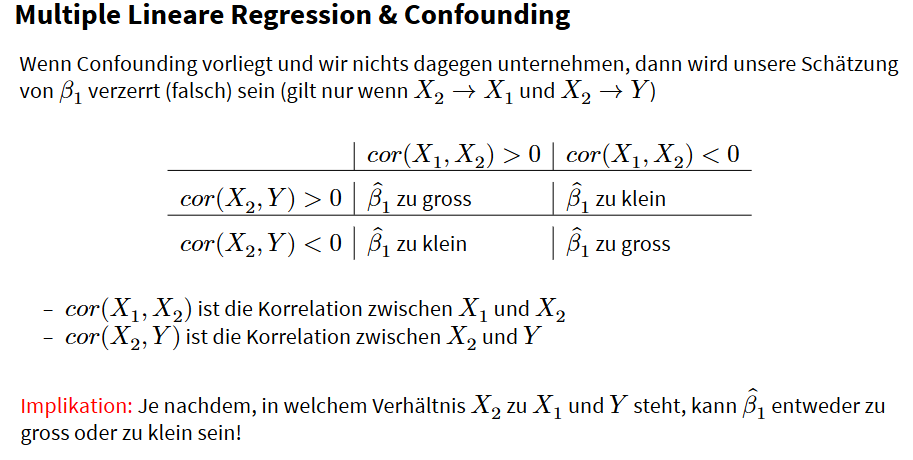
- wenn wir nichts gegen confounding unternehmen, passiert folgendes in Tabelle oben
12.13 Wann ist Confounding ein Problem?
Wenn die unabhängige Variable durch andere Faktoren beeinflusst wird und die abhängige Variable auch von diesen Faktoren beeinflusst wird
12.14 Wie können wir für Confounders «kontrollieren»?
Verwendung von Subklassifikation
Durch die Verwendung der multiplen Regression
12.15 Was ist Subklassifikation?
Unterschiede zwischen treatment und control Gruppe innerhalb der Stufen einer Störvariable
Stufen z.B. bei Einkommen: hoch, mittel, niedrig
12.16 Für Confounders kontrollieren mit Regression:
- Alle möglichen Variablen in Regression hinzufügen
12.17 Problem:
- Um zu behaupten, dass Schätzungen, die auf multiplen linearen Regressionen unter Verwendung von Beobachtungsdaten beruhen, kausale Effekte darstellen, müssen Sie argumentieren können, dass Sie für alle möglichen Störvariablen kontrolliert haben.
12.18 Das ist nicht möglich weil:
- Nicht alle Störfaktoren gekannt, gemessen und/oder beobachtet werden können.
12.19 Selection on observables
- in diesen Fällen unterscheiden sich die treatment und control Gruppe nur durch eine Reihe von beobachtbaren Merkmalen.
12.20 Interpretation von Koeffizienten (kausal)
12.20.1 1. Randomisierte Experimente
- Der Koeffizient für eine binäre Behandlung ist ein Schätzwert für den durchschnittlichen Behandlungseffekt
12.20.2 2. Beobachtungsstudien
Confounder: Variablen, die sowohl die treatment als auch das Ergebnis verursachen
Wir können Koeffizienten nur dann kausal interpretieren, wenn wir für alle Confounder als zusätzliche X-Variablen kontrolliert haben (Querschnittsdesign, Selektion auf beobachtbare Variablen, “Kontrolle für alle potenziellen Confounder”) oder wenn wir alternative Designs verwenden, wie wir in ein paar Wochen sehen werden (bspw. difference-in-differences)
13 VL 07: Panel Daten
13.1 Design-basierte kausale Inferenz
Man kann nicht alles Randomisieren
Wir müssen für alle Confounders kontrollieren können um mit Beobachtungsdaten Kausalität herzustellen könne
Panel Daten = neue Modelkategorie zur Identifizierung von kausalen Effekten
13.2 Panel Daten
Panel Daten = sind wiederholte Beobachtungen derselben Einheiten, bspw. 58 Länder über 15 Jahre
Panel Daten haben mehrere Beobachtungen für jede Einheit i
I = Bezeichnet Einheiten, t = unterschiedliche Zeitpunkte der Messung
13.3 Fixed effects Modell mit Panel Daten
13.4 Pooled data Regression
Wir schätzen Regression ohne die Zeitdimension zu berücksichtigen → pooled model
Wäre kausal, wenn es keine Confounding Variablen gibt
13.5 «Unit fixed» Modelle
Modell, bei dem wir für jede Einheit eine Dummy Variable bis auf eine Einheit ergänzt haben.
Wir halten eine Variable konstant
13.6 Vorteile:
- Ermöglicht die Kontrolle für alle «zeitvarianten» confounder
13.7 Nachteile:
- Wir haben unsere Schätzungen geändert
13.8 Zeitliche fixed effects
Das selbe wie mit den units, einfach für die Zeit
Was bedeutet es die Zeit konstant zu halten?
- Die zeitlichen fixed effects bedeuten, dass die Regressionslinien für jedes Jahr die gleiche Steigung haben und parallel zueinander verlaufen.
13.9 Vorteile:
- Ermöglicht die Kontrolle für alle “zeitvariierenden” confounder, die alle Einheiten betreffen (auch “einheiteninvariant” genannt)
13.10 Nachteile:
- Wir haben unsere Schätzungen geändert -> kein Vergleich mehr zwischen den Jahren
13.11 Two-way-fixed effects
Gleichzeitig wird Zeit und Land kontrolliert
Wir bereinigen länderspezifische und zeitspezifische confounders
13.12 Observational research designs
13.12.1 1. Cross-sectional designs
- Vergleich der Ergebnisse von Einheiten mit und ohne treatment, möglicherweise unter Berücksichtigung der Merkmale vor dem Treatment
13.12.2 2. Panel data designs
- Vergleich der Ergebnisse im Zeitverlauf und zwischen den Einheiten
13.12.3 3. Before and after designs
- Vergleich der Ergebnisse vor und nach treatment für ge-treatete Einheiten anhand von Langzeitdaten
13.12.4 4. Difference-in-differences designs
- Vergleich der Ergebnisse vor und nach treatment für ge-treatete Einheiten und Vergleich mit der gleichen Veränderung im Laufe der Zeit für Kontrolleinheiten
14 VL 09: Difference in Differences
14.1 Repetition: Design-based causal inference
Fundamentales Problem der kausalen Inferenz: Confounding
Lösung: Randomisierung
Aber: Wir arbeiten auch mit Beobachtungsdaten
Man muss für alle potentielle Confounder kontrollieren können bei Querschnittsdaten
Bei Paneldaten können wir teilweise für unbeobachtete Confounders kontrollieren (fixed effect modell)
14.2 Querschnittdaten
Definition Querschnittsdaten: Wenn wir mehrere Einheiten, wie Restaurants, Länder oder Einzelpersonen, zu einem Zeitpunkt beobachten, sprechen wir von einem Querschnitt.
Before/After-Ansatz: Wir beobachten die Daten vor dem treatment und nach dem Treatment
Definition Zeitreihe: Wenn wir Daten von derselben Einheit zu mehreren Zeitpunkten beobachten, nennen wir dies eine Zeitreihe.
Definition Panel Daten: Wenn wir mehrere Einheiten zu verschiedenen Zeitpunkten beobachten, haben wir Panel Daten.
14.3 Before/after Designs
Daten: Viele Beobachtungen von getreateten Einheiten im Laufe der Zeit
Ansatz: Unterschied zwischen den durchschnittlichen Ergebnissen vor und nach Treatment
Vorteil: Einheits-spezifische Störfaktoren werden konstant gehalten
14.4 Vor/Nachteile Before/after Designs
14.4.1 Vorteile:
Berücksichtigt zeitinvariante Confounders, d.h., es werden einheits-spezifische Merkmale “konstant” gehalten, indem die Ergebnisse innerhalb der Einheiten über die Zeit verglichen werden.
Erfordert nur Daten von getreateten Einheiten
14.4.2 Nachteile:
Man braucht die Annahme, dass sich bei den getreateten Einheiten ausser dem Treatment nichts geändert hat
Erfordert Daten aus mehreren Zeitpunkten
14.5 Differences-in-differences Ansatz:
Daten: Viele Beobachtungen von verschiedenen Einheiten - gewisse Einheiten erfahren das Treatment in der Beobachtungsperiode und gewisse nicht
Ansatz: Differenz der durchschnittlichen Outcomes vorher und nachher für die Treatment Gruppe, verglichen mit der gleichen Differenz für die Kontrollgruppe
Vorteil: Einheiten-spezifische und (gewisse) Zeit-variierende Confounder können berücksichtigt werden
14.6 Berechnung der difference-in-differences-Schätzung anhand regression
Regression durchführen für (Y_{i,t}), bei der wir die Beobachtungen für jede Einheit in beiden Zeiträumen in den Datensatz aufnehmen
Dann eine die Interaktion für eine Dummy-Variable der Zeitperiode (nach/vor treatment) und einer Dummy-Variable, welche angibt ob die Einheit das Treatment erhält, einschliessen
Daraus ergibt sich diese Regressionsgleichung:
\[ \hat{fullProp}_{i,t} = 0.31 - 0.01 \times location_i - 0.04 \times time_t + 0.06 \times location_i \times time_t \]
14.7 Difference in differences Design Zusammenfassung
14.7.1 Vorteile
Konstanthaltung von einheits-spezifischen Merkmalen durch den Vergleich von Ergebnissen innerhalb einer Einheit über die Zeit
Verhindert confounding durch Schocks, die für alle Einheiten (Treatment und Kontrolle) zum gleichen Zeitpunkt auftauchen
geht nicht davon aus, dass der Outcome ohne Treatment über die Zeit konstant bleibt
14.7.2 Nachteile
Erfordert die Annahme, dass sich nichts anderes nur für behandelte Einheiten geändert hat
- Wurden z. B. gleichzeitig andere politischen Schritte unternommen, die nur getreatete Einheiten betreffen?
Erfordert Daten von mehreren Einheiten über mehrere Zeitpunkte
14.8 Übersicht der verschiedenen Forschungsdesigns für Beobachtungsdaten
Querschnittsdesign: Vergleich der Ergebnisse von Treatment- und Kontroll-Gruppen, möglicherweise unter Berücksichtigung von weiteren Merkmalen
Vorher-Nachher-Design: Vergleich der Ergebnisse vor und nach Treatement für getreatete Einheiten anhand von Langzeitdaten
Difference-in-differences Design: Vergleich der Ergebnisse vor und nach Treatment für getreatete Einheiten und Vergleich mit der gleichen Veränderung im Laufe der Zeit für Kontrolleinheiten
14.9 Regression und Kausalität: Wann kann man einen Regressionskoeffizienten kausal interpretieren?
14.9.1 1. Randomisierte Experimente:
- Der Koeffizient für ein binäres Treatment ist eine Schätzung des ATE
14.9.2 2. Beobachtungsstudien:
- Wir können Koeffizienten nur kausal interpretieren, wenn wir für alle Confounders als zusätzliche X-Variablen kontrolliert haben
14.9.3 3. Vorher-Nachher Design:
- Unter der Annahme, dass es keine zeitvariierenden Confounders gibt, können Sie den durchschnittlichen kausalen Effekt schätzen, indem Sie die Differenz der Mittelwerte des Ergebnisses vor und nach der Behandlung ermitteln.
14.9.4 4. Difference-in-differences Design:
- Unter der Annahme paralleler Trends zwischen Kontroll- und Treatment-Gruppe (falls Treatment-Gruppe das Treatment nicht erhalten hätte) kann man den durchschnittlichen kausalen Effekt schätzen, indem man die Differenz der mittleren Veränderung in der Treatment- und der Kontrollgruppe nimmt.
14.9.5 5. Panel Daten Design:
- Unter der Annahme, dass es keine zeit- und einheitsvariierenden Confounders gibt, können Sie sich auf die Variation zwischen Treatment und Outcome in einer Einheit konzentrieren (mit unit-fixed-effects und time-fixed-effects)
15 VL 10: Unsicherheit I
15.1 Repetititon Mittelwertvergleich
Was ist ein “bedeutender” Unterschied? Zwei Ansätze zur Beantwortung der Frage:
- Sustantive Antwort: Berücksichtigen Sie die Einheiten, in denen sie gemessen wird.
- Statistische Antwort: Überlegen Sie, wie wahrscheinlich es ist, dass der in der Stichprobe beobachtete Unterschied nahe an dem in der Population vorhandenen Unterschied liegt.
15.2 Stichproben und Stichprobenverteilungen
einfache Zufallstichprobe = 𝑛 Einheiten werden nach dem Zufallsprinzip aus einer Population gezogen, und jede Einheit hat die gleiche Wahrscheinlichkeit, gezogen zu werden
Wahrscheinlichkeitsstichprobe = 𝑛 Einheiten werden nach dem Zufallsprinzip aus einer Population gezogen, und jede Einheit hat eine vorbestimmte Wahrscheinlichkeit, gezogen zu werden.
Warum sind Zufallstichproben nützlich? weil sie dazu beitragen, dass die Stichprobeneinheiten im Durchschnitt repräsentativ für die breitere Grundgesamtheit der Einheiten sind.
15.2.1 Stichprobenvariation
Stichproben helfen uns, das Problem zu überwinden, dass es oft unmöglich ist, die gesamte Bevölkerung zu beobachten.
Das hat aber seinen Preis: Die Grössen, die man anhand der Stichprobe berechnet, werden nicht genau den Wert der Grössen der gesamten Grundgesamtheit entsprechen.
15.2.2 Funktionen der Stichproben
Bei den meisten statistischen Methoden wird eine bestimmte Grösse für eine Stichprobe von Daten berechnet. Z.B: Mittelwert, Median, Modus, usw…
Solche grössen varieren auch wenn man eine Stichprobe zieht.
Wir müssen etwas darüber wissen, wie stark unsere interessierenden Grössen über mehrere Stichproben hinweg variieren, wenn wir verstehen wollen, wie viel eine einzelne Stichprobe über die Population aussagt, die uns interessiert.
15.2.3 Stichprobenvariation
Wie stark varriert die Differenz der Mittelwerte zwischen den Stichproben?
Wir ziehen immer neue Stichproben und erhalten eine Verteilung
Die Verteilung ist zentriert um den wahren Mittelwertsunterschied der Grundgesamtheit
Es besteht eine Variabilität von Stichprobe zu Stichprobe
Diese Verteilung nimmt eine ausgerprägte Glockenform an
15.2.4 Stichprobenverteilung
: Die Stichprobenverteilung ist die Verteilung der Werte, die sich aus der Berechnung der Differenz der Mittelwerte für viele Stichproben aus der Grundgesamtheit ergibt. – Die Stichprobenverteilung ist ein hypothetisches Konzept, bei den meisten Anwendungen beobachten wir nur eine Stichprobe, nicht viele. – Dasselbe gilt für potentielle Ergebnisse, von denen wir einige nicht beobachten können, die uns aber helfen, über die Logik der kausalen Schlüsse nachzudenken.
Standardbaweichung der Stichprobenverteilung
- die hat einen besonderen Namen: STANDARDFEHLER
15.2.5 Standardfehler
Der Standardfehler ist die geschätzte Standardabweichung der Stichprobenverteilung eines Schätzers (bspw. Mittelwertsdifferenz). Er beschreibt, um wie viel wir erwarten, dass die Mittelwertdifferenz in unseren Stichproben im Durchschnitt von der wahren Mittelwertdifferenz in der Grundgesamtheit abweicht.
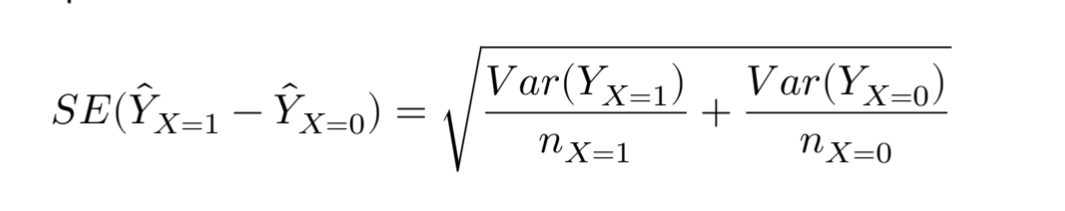
- Der Standardfehler nimmt zu, wenn die Varianz der darunterliegenden Variable 𝑉 𝑎𝑟(𝑌 𝑋=1 ) und 𝑉 𝑎𝑟(𝑌 𝑋=0 ) – zunimmt
- Der Standardfehler nimmt ab, wenn die Anzahl der Beobachtungen in jeder Gruppe 𝑛 𝑋=1 und 𝑛 𝑋=0 – steigt
15.3 Der zentrale Grenzwertsatz
15.3.1 Normalverteilung
- Definition
-
Die Normalverteilung ist eine Wahrscheinlichkeitsverteilung, die durch zwei Parameter beschrieben wird: den Mittelwert (𝜇) und die Varianz (𝜎 2 )
- Verteilung der Beobachtungen
-
– 68 % der Beobachtungen innerhalb von ±1 sd des Mittelwerts.
– 95% der Beobachtungen liegen innerhalb von ±1, 96 sd des Mittelwerts.
– 99% der Beobachtungen innerhalb von ±2, 58 sd des Mittelwerts.
15.3.2 Central Limit Theorem
Der zentrale Grenzwertsatz (CLT) besagt, dass die Verteilung von ̄ 𝑌 (der Stichprobenmittelwert) annähernd normal ist, wenn der Stichprobenumfang (𝑛) gross ist. Die Stichprobenverteilung ̄ 𝑌 ist:
exakt normal, wenn die Stichprobe aus einer Grundgesamtheit mit Normalverteilung gezogen wird
nahezu normal, wenn die Stichprobe aus einer Grundgesamtheit mit beliebiger Verteilung gezogen wird, solange 𝑛 ausreichend gross ist.
Wie gross “ausreichend gross” ist, hängt von der zugrundeliegenden 𝑌 -Verteilung ab (mindestens 𝑛 > 30).
15.3.2.0.1 Die Wichtige Erkenntnis des Central Limit Theorem
Wichtige Erkenntnis: Unabhängig von der Form der zugrunde liegenden Grundgesamtheit ist die Stichprobenverteilung der Stichprobenmittelwerte annähernd normalverteilt, solange der Stichprobenumfang gross genug ist.
Das Gleiche gilt für die Stichprobenverteilung der Mittelwertdifferenz
Dies ist nützlich, weil wir die Eigenschaften der Normalverteilung auf unsere geschätzte Differenz der Mittelwerte anwenden können
15.3.3 Wichtige Begriffe zusammengefasst
Stichprobenabweichung bedeutet, dass wir nicht sicher sein können, dass der Mittelwertunterschied in unserer Stichprobe ̄ 𝑌 𝑋=1 ̄ 𝑌 𝑋=0 gleich der Mittelwertdifferenz in der Grundgesamtheit ist.
Während wir die Stichprobenverteilung nicht direkt beobachten können, können wir den Standardfehler schätzen, der die Variabilität unserer Schätzungen zusammenfasst. Mit Hilfe des Standardfehlers können wir dann Konfidenzintervalle konstruieren.
- Konfidenzintervalle sind eine weitere Möglichkeit, die Unsicherheit über die Grundgesamtheit zu quantifizieren, die mit der Tatsache zusammenhängt, dass wir nur eine Stichprobe von Daten beobachtet haben.
15.4 Konfidenzintervalle
- Definition
-
Ein Konfidenzintervall ist ein Zahlenbereich, von dem man annimmt, dass er die wahre Differenz der Mittelwerte enthält. Konfidenzintervalle werden so konstruiert, dass sie die wahre Differenz der Mittelwerte in einem festen Anteil der Stichproben enthalten. Dies wird als Konfidenzniveau bezeichnet, das wir vor der Berechnung des Intervalls auswählen müssen. Implikation: Konfidenzintervalle quantifizieren unsere Unsicherheit, indem sie einen Bereich von Werten angeben, die wahrscheinlich den wahren Populationsunterschied der Mittelwerte einschliesst.
Berechnung von Konfidenzintervallen
- Wählen Sie ein Konfidenzniveau (in der Regel 95% oder 99%)
- Berechnen Sie die Differenz der Mittelwerte
- Berechnen Sie den Standardfehler
- Wählen Sie den kritischen Wert der Standardnormalverteilung, der dem Konfidenzniveau entspricht
- Der kritische Wert für das 95%ige Konfidenzniveau beträgt 1,96. –
- Der kritische Wert für das 99%ige Konfidenzniveau beträgt 2,58
- Berechnen Sie das obere und untere Ende des Konfidenzintervalls
Zusammenhang zwischen Konfidenzintervall und Stichprobenverteilung
– Die Stichprobenverteilung gibt Aufschluss darüber, wie die von uns berechnete Statistik in diesem Fall die Differenz der Mittelwerte - in den verschiedenen Stichproben um den Grundgesamtheitswert für diese Statistik herum variieren wird.
– Das Konfidenzintervall ist so konstruiert, dass es den Populationswert mit einer gewissen Wahrscheinlichkeit über verschiedene Stichproben hinweg einschliesst.
– Die Tatsache, dass die Stichprobenverteilung immer annähernd normal ist, bedeutet, dass der Standardfehler alles ist, was wir brauchen, um ein Konfidenzintervall für unsere Schätzung der Mittelwertdifferenz zu berechnen.
15.4.1 t-Verteilung
t-Verteilung kommt einer Normalverteilung sehr nahe, es sei denn, die verwendete Stichprobengrösse ist sehr klar
Die Konfidenzintervalle, die unter der Annahme berechnet werden, dass es sich bei der Stichprobenverteilung um eine t-Verteilung handelt, werden bei sehr kleinen Stichprobengrössen etwas breiter sein, sind aber bei den meisten Datensätzen nicht zu unterscheiden.
15.4.2 Was bestimmt die Breite des Konfidenzintervalls?
- den kritischen Wert: Grössere kritische Werte führen zu breiteren Intervallen
- den Standardfehle: grössere Standardfehler führen zu breiteren Intervallen
16 VL: 11 Unsicherheit II
16.1 Wichtige Begriffe/Konzepte
P-Wert: gibt an, wie hoch die Wahrscheinlichkeit ist, dass die von uns beobachteten Daten unter der Annahme, dass die Nullhypothese wahr ist, beobachtet werden.
Nullhypothese: Gegenstück zur Hypothese (Annahme, dass es keinen Unterschied gibt)
16.2 Hypothesentest
- Nennen Sie die Hypothese und die Nullhypothese
- Berechnen Sie eine Teststatistik
- Bestimmung der Stichprobenverteilung der Teststatistik unter der Annahme, dass die Nullhypothese wahr ist
- Berechnen Sie den p-Wert 5. Nennen Sie eine Schlussfolgerung
16.3 Wann wird die Nullhypothese verworfen?
Wir lehnen die Nullhypothese ab, wenn es unwahrscheinlich ist, dass der von uns beobachtete Zusammenhang zwischen zwei Variablen zufällig zustande gekommen ist.
Diese Wahrscheinlichkeit wird als 𝛼-Level bezeichnet und hat in der Regel einen Wert von 0,05 oder 0,01.
16.3.1 Konfidenzintervall und alpha
| Alpha | Konfidenzniveau |
|---|---|
| 0,05 | 95% |
| 0,01 | 99 |
16.3.2 Typ 1 vs. Typ 2 Fehler
Typ 1 Fehler:
Wenn wir eine Nullhypothese ablehnen, diese aber wahr ist
Oder wenn wir Unterstützung für eine Hypothese finden, die falsch ist
Typ 2 Fehler:
Wenn wir eine falsche Nullhypothese nicht zurückweisen können
Oder wenn wir keine Unterstützung für eine Hypothese finden, obwohl sie wahr ist
t-tests für die Differenz zweier Mittelwerte
Ein t-Test kann verwendet werden, um einen Hypothesentest für die Differenz der Mittelwerte zwischen zwei Gruppen durchzuführen
Erfordert eine abhängige Variable auf Intervallskalenniveau (Y) und eine binäre unabhängige Variable (X)
16.3.2.1 Teststatistik
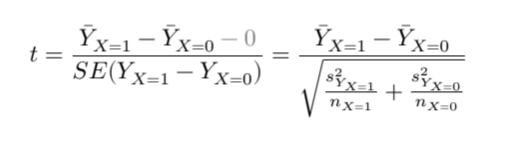
Intuition
Mehr Anzeichen für einen Unterschied in der Grundgesamtheit, wenn der Mittelwertunterschied in der Stichprobe grösser ist
Mehr Hinweise auf Unterschiede in der Grundgesamtheit, wenn der Standardfehler kleiner ist
t misst die Anzahl der Standardfehler, die den Mittelwert einer Gruppe vom Mittelwert einer anderen Gruppe trennen
16.4 P-Werte
- P-Wert Definition
-
Der p-Wert ist die Wahrscheinlichkeit, dass die in unserer Stichprobe beobachtete Teststatistik oder ein noch extremerer Wert auch in anderen Stichproben der Grundgesamtheit auftreten würde, wenn die Nullhypothese wahr wäre.
16.4.1 P-Werte und t-Statistiken
Interpretation
Eine grosse t-Statistik ist Evidenz gegen die Nullhypothese
Ein kleiner p-Wert ist Evidenz gegen die Nullhypothese
16.5 Konfidenzintervalle
Von Hypothesentests zu Konfidenzintervallen
Man kann neue Werte für die Nullhypothese schauen
Testen, um zu sehen, ob wir die Null zurückweisen können
Wenn man diesen Prozess fortsetzt erhält man eine Reihe von Werten für die Differenz der Mittelwerte der Grundgesamtheit, die mit einem Konfidenzniveau von 95% nicht zurückgewiesen werden können
Dieser Satz von Werten wäre unser 95%-Konfidenzintervall
Alpha und das Konfidenzniveau
Beachten Sie, dass Hypothesentests und Konfidenzintervalle für ein bestimmtes Konfidenzniveau immer das gleiche Ergebnis liefern:
Wenn die Nullhypothese für den Mittelwertunterschied 0 ist und wir die Nullhypothese bei einem Konfidenzniveau von 95 % mit Hilfe eines Hypothesentests zurückweisen, liegt der Wert 0 nicht innerhalb des 95 %-Konfidenzintervalls!
Wenn ein 95%-Konfidenzintervall den Wert 0 nicht einschliesst, wissen wir, dass wir die Nullhypothese auch bei einem Hypothesentest mit 𝛼 = 0, 05 zurückweisen würden.
16.6 Unsicherheit in der Regression
Standardfehler der Regressionskoeffizienten:
Der Standardfehler der Regressionskoeffizienten funktioniert auf die gleiche Weise wie der Standardfehler der Mittelwertdifferenz:
Er quantifiziert den Grad der Variabilität, den wir bei vielen Stichproben erwarten würden: die Stichprobenverteilung
Der zentrale Grenzwertsatz besagt, dass dies alles ist, was wir über die Stichprobenverteilung der Regressionskoeffizienten wissen müssen, da diese Stichprobenverteilung eine Normalverteilung ist.
16.7 Hypothesentest für Regression
Die Hypothesentests für die Regressionskoeffizienten sind denen für die Differenz der Mittelwerte sehr ähnlich:
1. Bestimmen Sie eine Hypothese und eine Nullhypothese
2. Berechnen Sie die Test-Statistik
3. Bestimmung der Stichprobenverteilung der Teststatistik unter der Annahme, dass die Nullhypothese wahr ist
4. Berechnen Sie den p-Wert
5. Nennen Sie eine Schlussfolgerung
Teststatistik für Regressionskoeffizienten
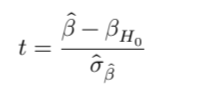
- wobei omega der Standardfehler von beta ist
16.7.0.1 Stichprobenverteilung von t
wenn n gross ist (>30) impliziert der zentrale Grenzwertsatz, dass t der Standardnormalverteilung folgen wird
wenn n klein ist (<30) wird t einer t-Verteilung mit n-1 Freiheitsgraden folgen
Implikation
- Zur Beurteilung der Signifikanz können wir dieselben Faustregeln wie zuvor anwenden
16.7.0.2 Statistische Bedeutung
Nullhypothese meistens, dass der Koeffizient gleich null ist
Man kann aber auch die Hypothesentests benutzen zum andere Nullhypothesen zu testen
16.7.1 Sterndeutung in R
. = signifikant bei 90% Konfidenznieveau
“*” = signifikant bei 95% Konfidenzniveau
“**” = signifikant bei 99% Konfidenzniveau
“***” = signifikant bei 99,9 % Konfidenzniveau
17 VL 12: Binäre Modelle I
17.1 Binäre Variablen
auch “dummy” Variable gennant
können nur zwei Werte annehmen (oft 1 und 0)
werden verwendet um anzuzeigen, ob eine Beobachtung eine spezifische Eigenschaft aufweist oder nicht.
17.2 Bernoulli-Variable
Verteilung, mit der wir binäre Variablen beschreiben können
Der Erwartungswert ist gleich dem Parameter 𝜋: 𝐸(𝑋 𝑏𝑒𝑟 )=𝜋
Es gilt auch 𝑝(𝑋 = 1) = 𝜋
17.3 Lineares Wahrscheinlichkeitsmodell (LPM)
𝑦 𝑖 =𝛽 0 +𝛽 1 ⋅𝑥 𝑖 +𝜀 𝑖
Wenn Y binär ist, dann gilt, dass wir nicht direkt y vorhersagen, sondern die Wahrscheinlichkeit vorhersagen, dass y = 1 ist.
17.4 Vorteile des LPM
bekanntes Modell
Einfach in der Interpretation
Können also auch unterschiedliche Effekte für bspw. die Geschlechter modellieren
17.5 Vorhersagen im LPM
es können negative Werte entstehen -> ABER: Wahrscheinlichkeiten können NICHT negativ sein!
offensichtliches Problem des LPMs
Nichts hindert in einem OLS Modell dass die Werte nicht unter 0 oder über 1 sind
17.6 Modelle mit Mantelfunktion
Wir stülpen um die Regression eine Mantelfunktion F(X)
Es hat keinen Fehlerterm, da wir Wahrscheinlichkeiten schätzen
- Wahrscheinlichkeiten brauchen keinen Fehlerterm, da diese sowieso schon Unsicherheit ausdrücken
17.6.1 Zwei Arten von Mantelfunktionen
probit = Normalverteilung
logit = logistische Verteilung
17.7 Vorhersagen in binären Modellen
- Wir stellen die X Werte fest für die wir eine Vorhersage machen wollen.
- Wir nehmen die geschätzten Koeffizienten des Modells und
- berechnen den Ausdruck 𝛽 0 +𝛽 1 ⋅𝑥 1 + … + 𝛽 𝑛 ⋅𝑥 𝑛
- und wir verwenden die Mantelfunktion
17.7.1 Probit oder Logit?
Die Richtung und Signifikanz ist gleich
geschätzte Werte sehen leicht anders aus
Vorhergesagte Werte sind fast identisch
18 VL 13: Binäre Modelle II
18.1 Modellqualität
Für die lineare Regression können wir mit \(R^2\) und adjustiertem \(R^2\) arbeiten
Bei binären Modellen gibt es kein \(R^2\) wie in der linearen Regression.
Wir nutzen die Vorhersagegüte
Vorhersagegüte = Funktion des Anteils korrekt vorhergesagter Beobachtungen
18.2 Vorhersagen
Bei logit & probit sind Vorhersagen Wahrscheinlichkeiten
Um zu bestimmen, ob eine Vorhersage korrekt ist oder nicht, wenden wir folgende Regel an:
p < 0.5 interpretieren wir als y = 0
p > 0.5 interpretieren wir als y = 1
Korrekte Vorhersagen sind dann diejenigen Beobachtungen, bei denen \(\hat{Y} = Y\) gilt
18.3 Naives Modell
Es ist ein Modell ohne erklärende Variablen \(X\), also einfach \(P(Y = 1) = F(\beta_0)\). Man kann also nicht zwischen Beobachtungen unterscheiden.
Konsequenz: Für alle Beobachtungen wird dieselbe Vorhersage gemacht.
18.4 Modellgüte
- Wir evaluieren die Modellgüte eines Logit/Probit-Modells, indem wir den Anteil korrekt vorhergesagter Beobachtungen mit dem Anteil korrekt vorhergesagter Beobachtungen bei einem naiven Modell vergleichen.
18.4.1 PRE: Wie stark verkleinert ein Modell den Fehler?
- Berechnen können wir das, indem wir die Fehlerreduktion ins Verhältnis zum Fehler setzen.
18.5 Interpretation der Schätzergebnisse
Wir haben gesehen, dass im linearen Regressionsmodell der Koeffizient auch gleichzeitig die Veränderung von \(Y\) anzeigt, wenn \(X\) um eine Einheit steigt – dies gilt NICHT mehr für Logit/Probit.
Der marginale Effekt hängt davon ab, wo man sich in der S-Kurve „befindet“.
- keine einfache Interpretation mehr
Die Veränderung in der Wahrscheinlichkeit \(P(Y = 1)\) ist aber abhängig davon, welche Werte man auf allen erklärenden Variablen annimmt.